推理服务与集成
vLLM 推理服务
问:我们会直接管理 vLLM 属性用于调优,在 HCS ModelArts 上如何处理?
答:对于 vLLM 属性:1. 运营方用户可以在创建推理模板时管理 vLLM 属性。2. 如果客户不使用推理模板部署,也可以在启动命令中定义 vLLM 属性。
问:如何采集推理服务指标?
答:当使用 vLLM 框架启动推理服务时,metrics exporter 会被启用,指标可以通过 API 访问。
其他推理服务
问:除 vLLM 外,还支持哪些推理服务?
答:除 vLLM 外,也可以定制包含其他 AI 框架的推理基础镜像,例如 SGLang 和 MindIE。
参考推理服务包括:
- VLLM
- Llama-server(llama.cpp)
问:HCS 基础镜像中 vLLM 的支持状态如何?
答:推理基础镜像可以基于 vLLM,也可以定制为包含 SGLang、MindIE 等其他 AI 框架。每个框架的启动属性都可以管理。运营方用户也可以为不同 AI 框架环境的镜像设置不同标签,用于推理、训练或开发 IDE 等不同场景。
平台迁移
问:代码转换需要多少工作量?
答:现有 OpenShift AI 部署不能直接兼容 HCS ModelArts,需要重新部署。
问:将现有部署从 OpenShift AI 迁移到 HCS ModelArts 需要什么?
答:现有 OpenShift AI 部署不能直接兼容,需要重新部署。不过,已部署在 OpenShift AI 上的模型可以通过配置 endpoint、API key 和 model ID,在 AGIOne 中发布为模型服务。
客户端 - LLM 集成
问:客户端集成是否需要变更或额外工作?
答:平台提供模型服务。如果使用固定的 model ID、endpoint 和 API key,客户端不需要变更。
问:如果 Qwen 3.5 235B 模型运行在 OpenShift(NVIDIA)或 HCS(Atlas)上,平台迁移是否需要客户端变更?
答:平台提供模型服务。如果 Qwen 3.5 235B 模型部署在 OpenShift(NVIDIA)或 HCS(Atlas)上,这些部署可以聚合为一个模型服务,并使用固定的 model ID、endpoint 和 API key。在这种情况下,客户端不需要变更。
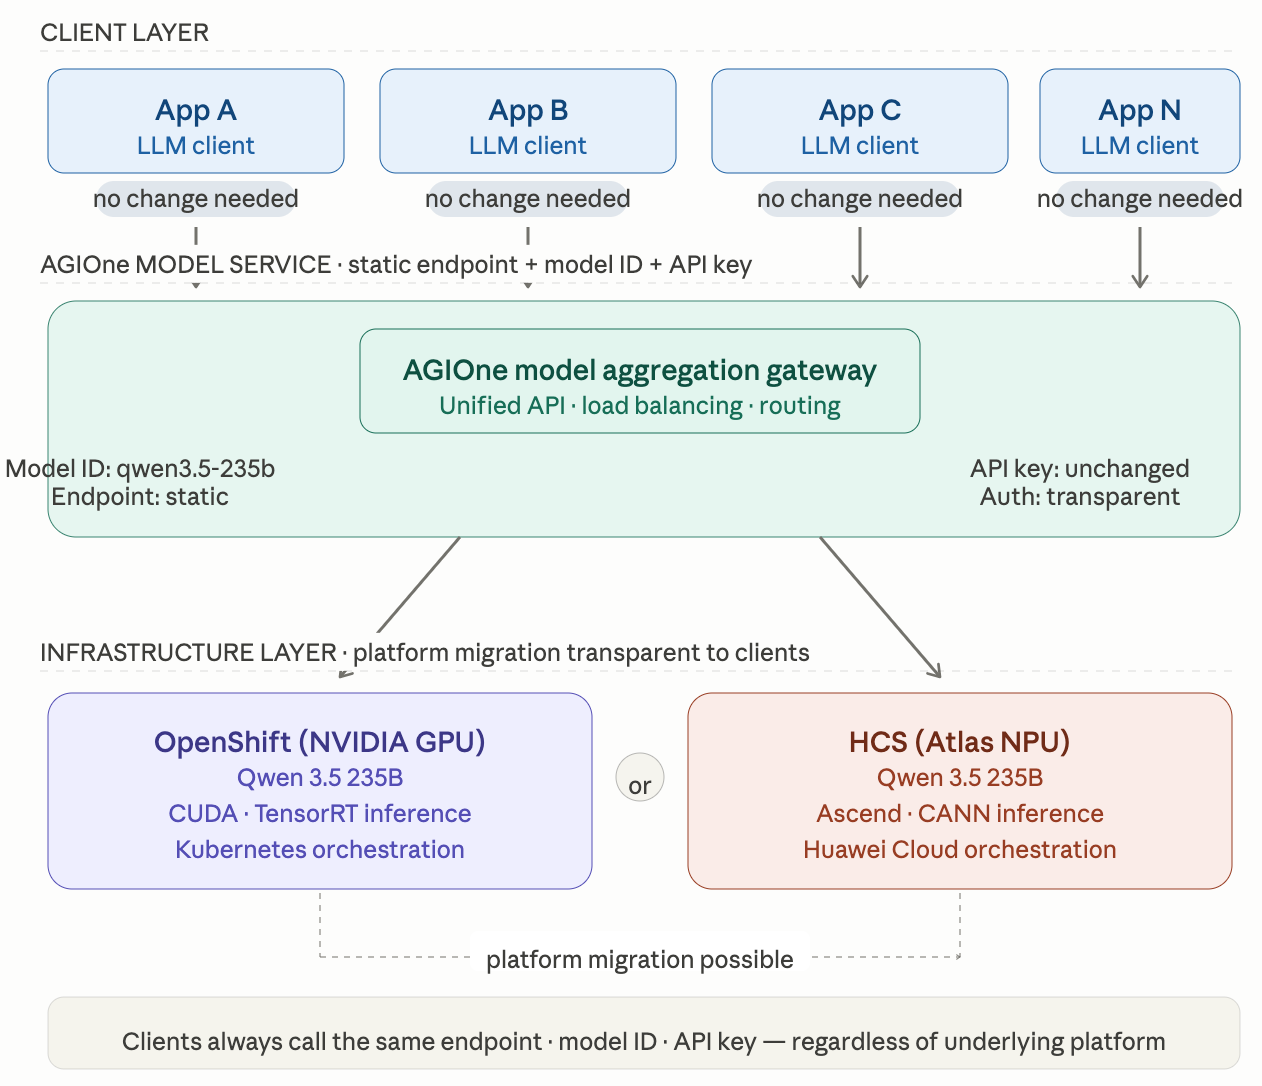
客户端层:所有应用(App A、B、C ... N)都使用一组固定凭证接入模型服务,包括固定 endpoint URL、固定 model ID(qwen3.5-235b)和一个 API key。无论底层部署如何变化,这些凭证都保持不变。
AGIOne 模型服务(聚合网关):这是关键的抽象层。它提供统一 API 入口,并在后端部署之间处理请求路由、负载均衡和故障切换。从客户端视角看,只需要访问这一层,底层基础设施是透明的。
基础设施层:Qwen 3.5 235B 可以同时部署在一个或两个平台上:
- OpenShift(NVIDIA GPU):在 Kubernetes 编排下运行 CUDA/TensorRT 推理。
- HCS(Atlas NPU):在华为云上运行 Ascend/CANN 推理。
平台迁移的核心价值: 聚合网关将 API 契约与物理部署解耦。因此,两个后端可以并行运行、灵活切换或逐步迁移,而无需通知客户端团队。网关在内部处理所有路由复杂度,客户端无需变更。
LLM as a Service / SLA
问:AGIOne 为 LLM as a Service / SLA 提供哪些可用性机制?
答:AGIOne 支持聚合同类型的多个模型来源,并内置 failback 和熔断机制。
如果某个模型连续失败,该模型会被临时熔断,直到检测到其恢复可用。
如果某次请求失败,AGIOne 会自动切换并将请求路由到下一个候选模型。
这些机制有助于保障本地化部署场景下的模型可用性。
多租户模型方案
问:当多个租户使用同一个模型并共享 GPU 提供服务时,HCS 推理服务提供哪些能力?
答:支持 KV cache 和前缀缓存。对于这些缓存能力,不区分不同客户的调用。
相关能力包括:
- KV cache 隔离
- 自动前缀缓存